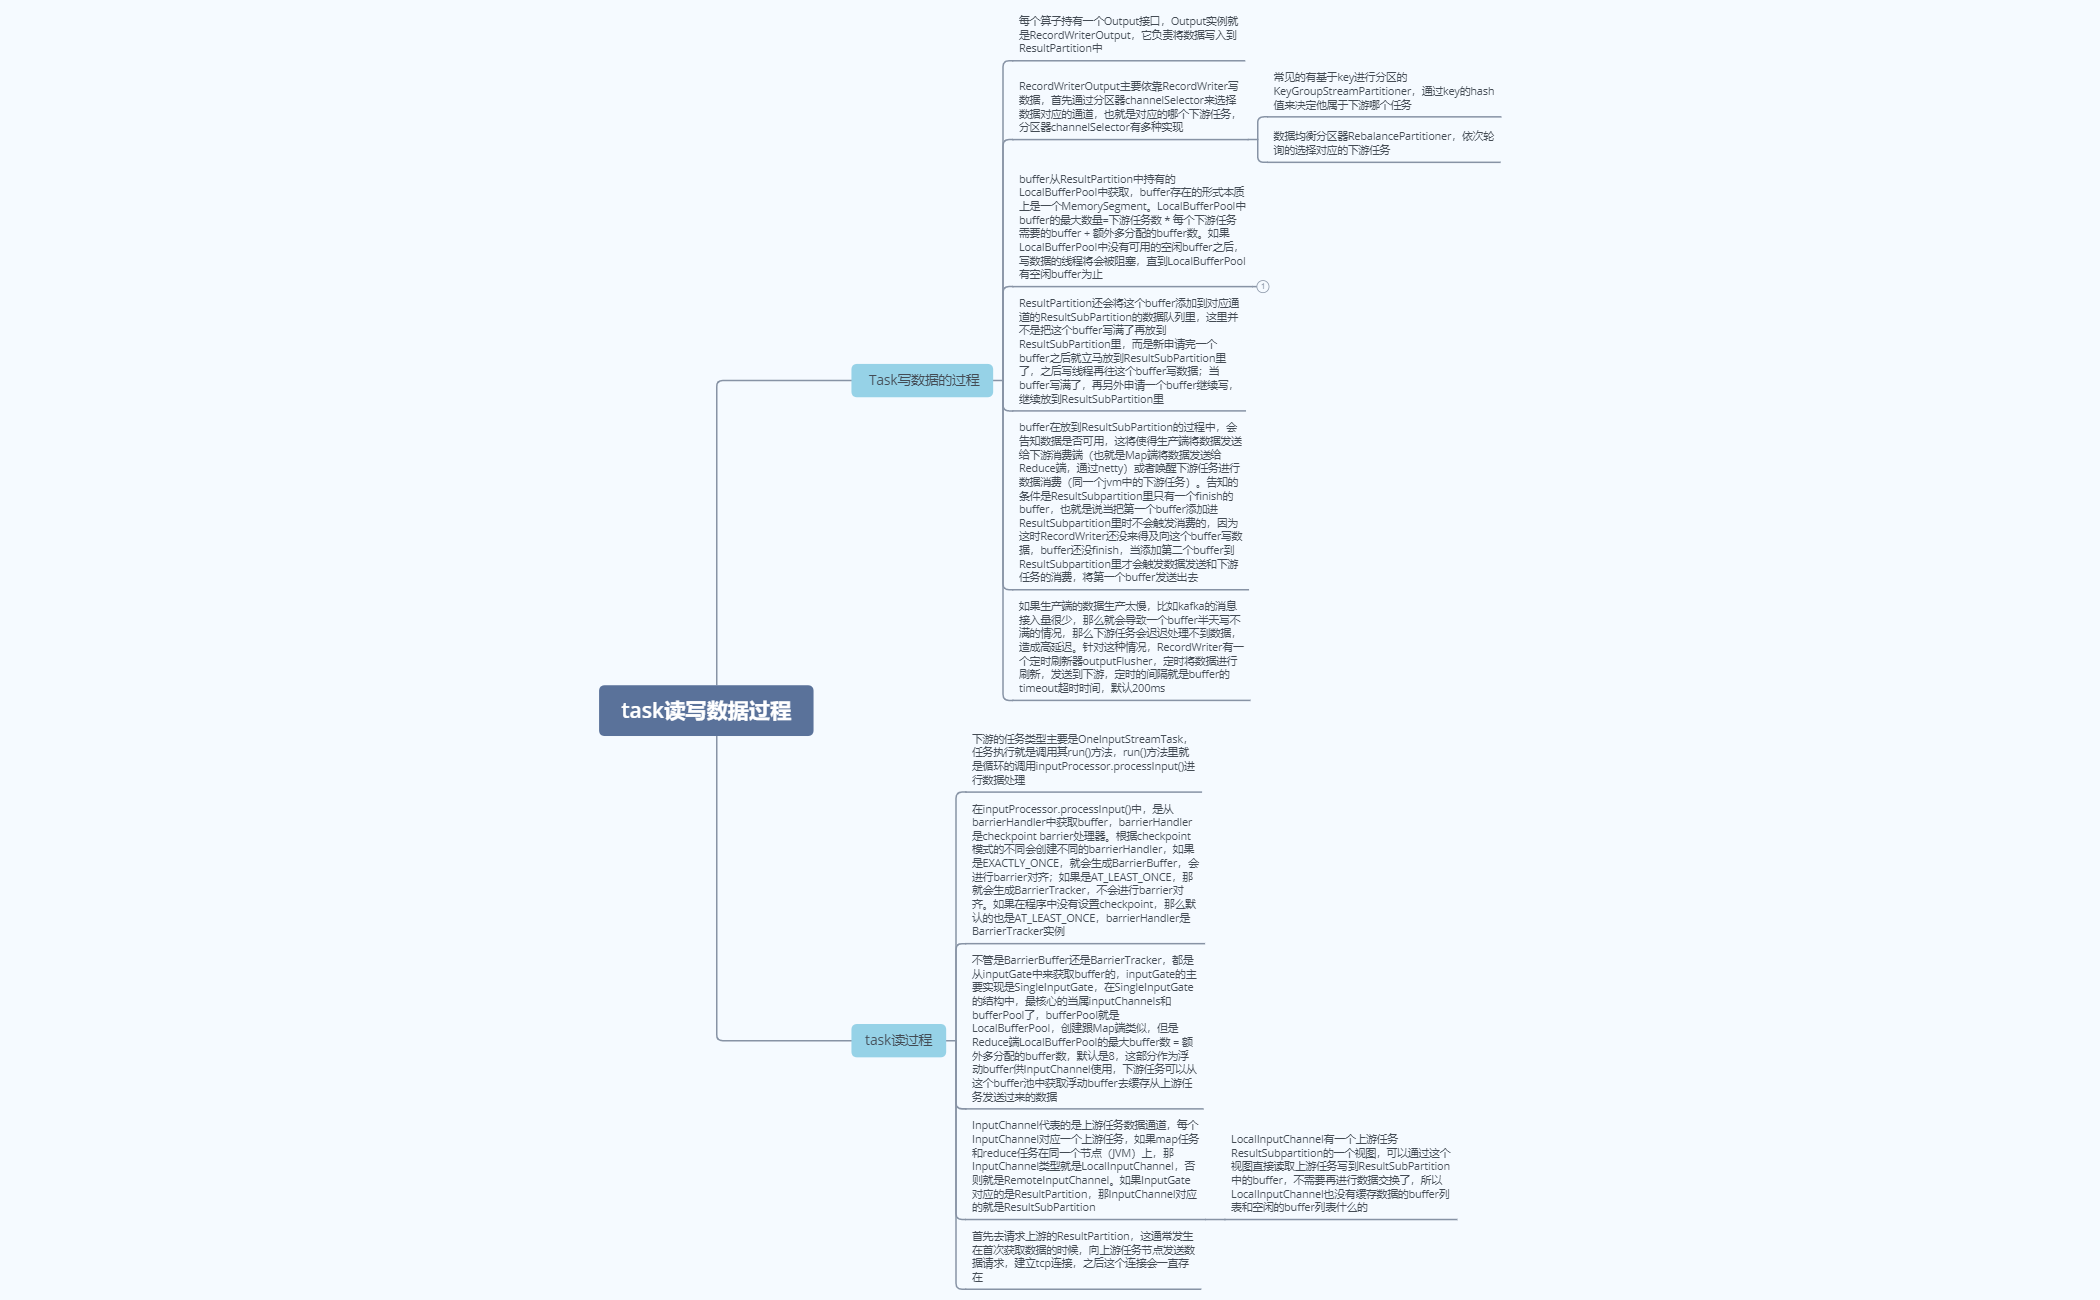
Task写数据的过程
每个算子持有一个Output接口,Output实例就是RecordWriterOutput,它负责将数据写入到ResultPartition中
RecordWriterOutput主要依靠RecordWriter写数据,首先通过分区器channelSelector来选择数据对应的通道,也就是对应的哪个下游任务,分区器channelSelector有多种实现
- 常见的有基于key进行分区的KeyGroupStreamPartitioner,通过key的hash值来决定他属于下游哪个任务
- 数据均衡分区器RebalancePartitioner,依次轮询的选择对应的下游任务
buffer从ResultPartition中持有的LocalBufferPool中获取,buffer存在的形式本质上是一个MemorySegment。LocalBufferPool中buffer的最大数量=下游任务数 * 每个下游任务需要的buffer + 额外多分配的buffer数。如果LocalBufferPool中没有可用的空闲buffer之后,写数据的线程将会被阻塞,直到LocalBufferPool有空闲buffer为止
- NetworkBufferPool 会计算剩余空闲的内存块 数量,并平均分配给已创建的缓冲池这个过程只是指定了缓冲池所能使用的内存块 数量,并没有真正分配内存块,只有当需要时才分配。为什么要动态地为缓冲池扩容呢?因 为内存越多,意味着系统可以更轻松地应对瞬时压力(如 GC),不会频繁地进入反压状态, 所以我们要利用起那部分闲置的内存块
ResultPartition还会将这个buffer添加到对应通道的ResultSubPartition的数据队列里,这里并不是把这个buffer写满了再放到ResultSubPartition里,而是新申请完一个buffer之后就立马放到ResultSubPartition里了,之后写线程再往这个buffer写数据;当buffer写满了,再另外申请一个buffer继续写,继续放到ResultSubPartition里
buffer在放到ResultSubPartition的过程中,会告知数据是否可用,这将使得生产端将数据发送给下游消费端(也就是Map端将数据发送给Reduce端,通过netty)或者唤醒下游任务进行数据消费(同一个jvm中的下游任务)。告知的条件是ResultSubpartition里只有一个finish的buffer,也就是说当把第一个buffer添加进ResultSubpartition里时不会触发消费的,因为这时RecordWriter还没来得及向这个buffer写数据,buffer还没finish,当添加第二个buffer到ResultSubpartition里才会触发数据发送和下游任务的消费,将第一个buffer发送出去
如果生产端的数据生产太慢,比如kafka的消息接入量很少,那么就会导致一个buffer半天写不满的情况,那么下游任务会迟迟处理不到数据,造成高延迟。针对这种情况,RecordWriter有一个定时刷新器outputFlusher,定时将数据进行刷新,发送到下游,定时的间隔就是buffer的timeout超时时间,默认200ms
task读过程
下游的任务类型主要是OneInputStreamTask,任务执行就是调用其run()方法,run()方法里就是循环的调用inputProcessor.processInput()进行数据处理
在inputProcessor.processInput()中,是从barrierHandler中获取buffer,barrierHandler是checkpoint barrier处理器。根据checkpoint模式的不同会创建不同的barrierHandler,如果是EXACTLY_ONCE,就会生成BarrierBuffer,会进行barrier对齐;如果是AT_LEAST_ONCE,那就会生成BarrierTracker,不会进行barrier对齐。如果在程序中没有设置checkpoint,那么默认的也是AT_LEAST_ONCE,barrierHandler是BarrierTracker实例
不管是BarrierBuffer还是BarrierTracker,都是从inputGate中来获取buffer的,inputGate的主要实现是SingleInputGate,在SingleInputGate的结构中,最核心的当属inputChannels和bufferPool了,bufferPool就是LocalBufferPool,创建跟Map端类似,但是Reduce端LocalBufferPool的最大buffer数 = 额外多分配的buffer数,默认是8,这部分作为浮动buffer供InputChannel使用,下游任务可以从这个buffer池中获取浮动buffer去缓存从上游任务发送过来的数据
InputChannel代表的是上游任务数据通道,每个InputChannel对应一个上游任务,如果map任务和reduce任务在同一个节点(JVM)上,那InputChannel类型就是LocalInputChannel,否则就是RemoteInputChannel。如果InputGate对应的是ResultPartition,那InputChannel对应的就是ResultSubPartition
- LocalInputChannel有一个上游任务ResultSubpartition的一个视图,可以通过这个视图直接读取上游任务写到ResultSubPartition中的buffer,不需要再进行数据交换了,所以LocalInputChannel也没有缓存数据的buffer列表和空闲的buffer列表什么的