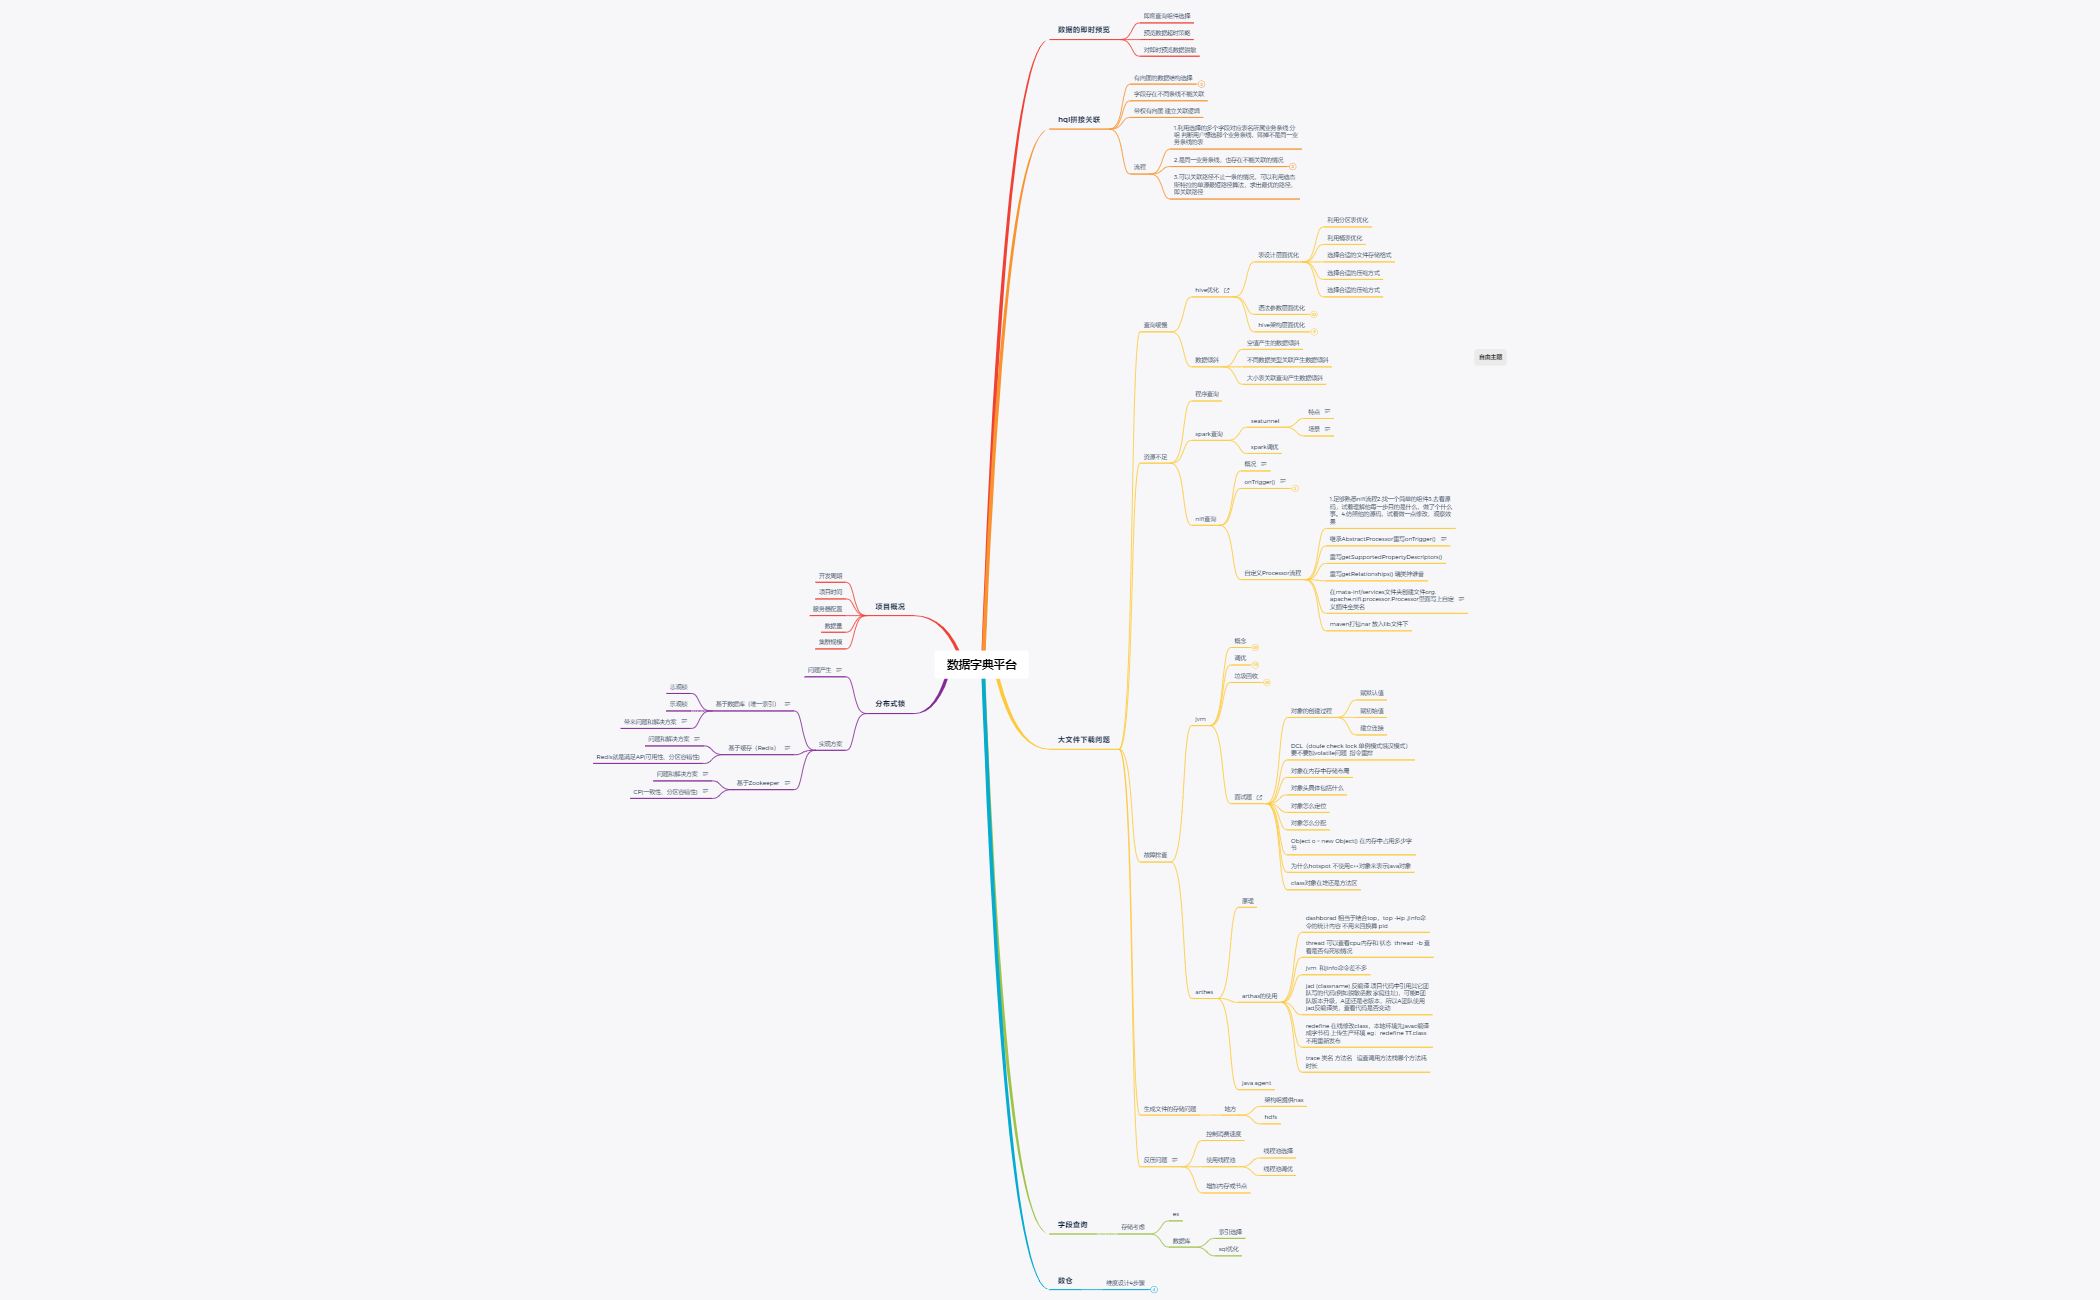
数据的即时预览
即席查询组件选择
预览数据超时策略
对即时预览数据脱敏
hql拼接关联
有向图的数据结构选择
- 邻接表
- 邻接矩阵
字段存在不同条线不能关联
带权有向图 建立关联逻辑
流程
-
1.利用选择的多个字段对应表名所属业务条线 分组 判断用户想选那个业务条线,筛掉不是同一业务条线的表
-
2.是同一业务条线,也存在不能关联的情况
- 1.在关系表中去除此次没有选择到的表并删除关联关系 对应 图中的边(关联关系)和顶点(表)
- 2.按数据库关系联系表生成一张有向带权图
- 3.按照预先规则,判断以那张表作为主表,也就确定以那顶点作为开始节点,然后进行图遍历(深度广度),形成列表,排除掉不在列表中的表
-
3.可以关联路径不止一条的情况,可以利用迪杰斯特拉的单源最短路径算法,求出最优的路径,即关联路径
大文件下载问题
查询缓慢
-
hive优化
-
表设计层面优化
- 利用分区表优化
- 利用桶表优化
- 选择合适的文件存储格式
- 选择合适的压缩方式
- 选择合适的压缩方式
-
语法参数层面优化
-
列裁剪(不需要的列不要select出来)
-
分区裁剪(查询的时候添加分区)
-
合并小文件(注意小文件产生的原因)
- Map 输入合并
- Map/Reduce输出合并
- 控制reduce个数来实现减少小文件个数
- combine
- jvm 重用(减少JVM开关时间)
-
合理控制 map/reduce 任务数量
-
Join优化
-
优先过滤数据(先过滤数据再join)
-
小表 join 大表原则(左边的表会被加载到内存中,防止OOM)
-
启用 mapjoin(在Map端进行join,减少了Reduce的步骤)
-
尽量原子操作(join的时候尽量不要join里面再套join,如果需要可以先建一个tmp表的方式,先算出来再join,也可以并行跑sql)
-
桶表 mapjoin
-
-
Group By 优化
- Map端部分聚合
- 有数据倾斜时进行负载均衡
-
Order By 优化
-
COUNT DISTINCT优化
-
一次读取多次插入
-
启用压缩
-
-
hive架构层面优化
- 本地化执行
- 启用直接抓取
- JVM重用
- 并行执行
- 推测执行
-
-
数据倾斜
- 空值产生的数据倾斜
- 不同数据类型关联产生数据倾斜
- 大小表关联查询产生数据倾斜
资源不足
-
程序查询
-
spark查询
-
seatunnel
-
特点
基于配置的低代码开发,易用性高,方便维护。 ⚫ 支持实时流式传输 ⚫ 离线多源数据分析 ⚫ 高性能、海量数据处理能力 ⚫ 模块化的插件架构,易于扩展 ⚫ 支持用 SQL 进行数据操作和数据聚合 ⚫ 支持 Spark structured streaming ⚫ 支持 Spark 2.x
-
场景
海量数据的同步 ⚫ 海量数据的集成 ⚫ 海量数据的 ETL ⚫ 海量数据聚合 ⚫ 多源数据处理
-
-
spark调优
-
-
nifi查询
-
概况
高度可配置的指示图的数据路由、转换和系统中介逻辑,支持从多种数据源动态拉取数据。 NiFi基于Web方式工作,后台在服务器上进行调度。 用户可以为数据处理定义为一个流程,然后进行处理,后台具有数据处理引擎、任务调度等组件。 强大: NIFI提供了许多开箱即用的处理器。 NIFI是高度并发的,但其内部封装了相关的复杂性。我们看到的处理器是一个高级抽象,它掩盖了并行编程固有的复杂性。我们可以多个处理器一起运行,一个处理器也可以有多个线程运行。
可靠: NIFI的设计实现具有扎实的理论基础。与SEDA之类的模型相似(SEDA全称是:stage event driver architecture,中文直译为“分阶段的事件驱动架构”,它旨在结合事件驱动和多线程模式两者的优点,从而做到易扩展,解耦合,高并发。各个stage之间的通信由event来传递,event的处理由stage的线程池异步处理。)。
-
onTrigger()
QuartzSchedulingAgent对应CRON driven TimerDrivenSchedulingAgent对应Timer driven+
ScheduledThreadPoolExecutor自定义了一个线程池FlowEngine(Timer Drriven和CRON Driven对应的是同一个线程池->FlowEngine实例 ScheduledThreadPoolExecutor继承了ThreadPoolExecutor,也就是说ScheduledThreadPoolExecutor拥有execute()和submit()提交异步任务的基础功能,它的构造方法实际上是调用了ThreadPoolExecutor,ScheduledThreadPoolExecutor实现了ScheduledExecutorService接口,该接口定义了可延时执行异步任务和可周期执行异步任务的特有功能.而延时执行异步任务和周期执行异步任务分别就是Apache NIFI CRON driven和Timer driven策略的实现核心所在。
共同受最大计时器线程计数(Max Timer Driven Thread Count)限制。
- Timer driven
- CRON driven
-
自定义Processor流程
-
1.足够熟悉nifi流程2.找一个简单的组件3.去看源码,试着理解他每一步目的是什么,做了个什么事。4.仿照他的源码,试着做一点修改,观察效果
-
继承AbstractProcessor重写onTrigger()
AbstractProcessor又继承AbstractSessionFactoryProcessor 主要 实现初始化的方法
AbstractSessionFactoryProcessor实现了 ConfigurableComponent 配置属性接口 和一个Processor接口,主要是路由关系方法
-
重写getSupportedPropertyDescriptors()
-
重写getRelationships() 瑞类神谁普
-
在mata-inf/services文件夹创建文件org.apache.nifi.processor.Processor里面写上自定义插件全类名
META-INF目录实际上就是描述jar文件中的信息的一个目录,目录中除了manifest.mf文件之外其实还是可以配置很多信息文件的,这些文件都是在应用程序运行的过程中向其提供jar文件的内容描述的。
-
maven打包nar 放入lib文件下
-
-
故障排查
-
jvm
-
概念
-
解释器 需要一句一句解释执行,即时编译器,把常用的语句(程序计数器)编译下来,就不用执行引擎一句句解释执行
-
jre = jvm + core lib jdk=jre+devlopment kit
-
class 文件
- class 版本
- 常量池
- 访问修饰符 public
- 实现接口个数及具体接口
- 父类
- 成员变量个数和变量
- 方法
-
类的生命周期
类从被加载到虚拟机内存中开始,到卸载出内存结束。
-
加载(Loading)
-
通过一个类的全限定名来获取定义此类的二进制字节流
二进制来源: zip包中获取 网络中获取 运行时计算生成 由其他文件生成 代理类的二进制流
-
将二进制字节流代表的静态存储结构转化为方法区的运行时数据结构
-
在内存中生成一个代表该类的java.lang.Class对象,作为方法区这个类各种数据的访问入口
-
懒加载
-
-
连接
-
验证(Verification)
确保Class文件的字节流中包含的信息符合虚拟机的要求,且不会危害虚拟机的安全。如果检查结果不符合虚拟机的要求,会抛出java.lang.VerifyError的异常或其子类异常
- 文件格式验证
- 元数据验证
- 字节码验证
- 符号引用验证
-
准备(Preparation)
- 正式为类变量分配内存并设置初始值
-
解析(Resolution)
- 把符号引用转换为直接引用
-
-
初始化(Initialization)
- 执行
(),初始化类变量、静态代码块
- 执行
-
使用(Using)
-
卸载(Unloading)
-
-
类加载器
-
自定义类加载
- 继承classload方法
- 重写findclass 调用define class方法
- 自定义类加载加载自加密的class类
-
-
硬件层数据一致性
-
-
调优
-
cpu飙高
-
运维团队发出报警信息
-
top先找到某个进程,top -Hp 查看该进程中哪个线程cpu使用高 命令观察cpu和内存占比高 和jstack中pid做对比 需要来回换算 一个十进制,一个十六进制
- gc线程 一定是在频繁gc,然后读gc日志,查看原因。可能是压力流量突然变大(撑不住就考虑扩机器) 还可能是内存泄漏
- 业务线程
-
jps 定位具体java进程 jstack 定位线程状况 重点关注:WAITING BLOCKED eg:wait on <0x 0000000088ca3310> (a java.lang.Object)
-
假如有一个进程100个线程 很多线程都在waiting on
,一定要找到是哪个线程持有这把锁怎么找?搜索jstack dump的信息,找 ,看哪个线程持有这把锁RUNNABLE -
所以阿里规范里规定,线程的名称尤其的线程池都要写有意义的名称 怎么样自定义线程池里的线程名称?(自定义ThreadFactory)
-
-
内存飙高
-
jinfo pid 查看虚拟的垃圾回收器 相关参数
-
jstat -gc 动态观察gc情况/阅读GC日志发现频繁GC/arthas观察/JVisualVm/jconsole/jprofiler eg:jstat -gc 4655 500 :每隔500个毫秒打印GC的情况 打印出的参数很抽象不好观察
-
(生产环境不能用,会让整个jvm卡死在某个状态然后收集,可以在测试环境压测分析在堆还不是很大的时候进行转储 ,流量复制一份打入备机)jmap -history 11988 |head -20 打印堆内 哪个对象实例个数和大小 jmap -dump:format=b,file=20230211.hprof 11988 生成堆转储文件 JVisualVm查看 可以在启动参数里添加 -XX:+HeapDumpOnOutofMemoryError 在内存满了之后自动转储一份
- 压测环境
- 项目做了负载均衡,把一台机器从均衡里面拿出做分析(有风险,可能打破平衡)
- 由于短时间tcp连接特别多,使用tcp dump复制一份流量在测试机做观察
-
-
-
垃圾回收
-
什么是垃圾?如何定位垃圾
-
引用计数算法
- 由于引用计数的算法存在无法解决循环引用的的问题,所以目前的垃圾回收器的查找需要回收的对象都是采用的根可达算法。
-
root可达算法
-
范围
- 虚拟机栈(栈桢中本地变量表)中引用的对象
- 本地方法栈中JNI(即一般说的Native方法)中引用的对象
- 运行时常量池引用的对象
- 方法区中类静态属性
- 方法区中Class对象
-
提升效率 避免从头扫描
-
OopMap(Ordinary Object Pointer)
扫描整个虚拟机栈并非易事,因为GC回收只应该只关心那些是Reference类型的数据,而那些非Reference类型的,如果GC线程也进行了扫描,那就是对资源和时间的浪费。 所以JVM就想了一个办法,可以利用空间换时间的方式,JVM在扫描虚拟机栈的时候为了避免全栈扫描而采用了一种OopMap(Ordinary Object Pointer Map)的数据结构。 可以把oopMap简单理解成是调试信息。 在源代码里面每个变量都是有类型的,但是编译之后的代码就只有变量在栈上的位置了。OopMap就是一个附加的信息,告诉你栈上哪个位置本来是个什么东西。 这个信息是在JIT编译时跟机器码一起产生的。因为只有编译器知道源代码跟产生的代码的对应关系。 对于JIT编译后的某些方法也会在特定的一些位置去维护OopMap,这些位置称为安全点(Safe Point),之所以要选择一些特定的位置来记录OopMap, 是因为如 果对每条指令(的位置)都记录OopMap的话,这些记录就会比较大,那么空间开销会显得不值得。选用一些比较关键的点来记录就能有效的缩小需要记录的数据量,但仍然能达到区分引用的目的。因为这样,HotSpot中GC不是在任意位置都可以进入,而只能在safepoint处进入。
通过OopMap,这样GC线程就避免了去扫描整个堆栈,直接去OopMap中找到那些属于GC Roots的引用,开始进行遍历,这样可以大大缩小根节点枚举的时间。
-
CardTable
有一种情况的跨代引用如果按照简单的根可达算法进行扫描会产生性能问题,比如:老年代对象持有年轻代对象的引用,在年轻代进行YGC的时候,如果要确定年轻代对象是否没有被老年代对象引用指向,就需要去扫描整个老年代,从而产生性能问题,所以为了解决这个问题,所以在HotSpot虚拟机中提出了一个CardTable的概念,用于记录下这些跨代引用的关系。 这样当老年代引用了年轻代的对象的时候,就会通过写屏障(Write Barrier)将老年代对象所在的CardPage标记为Dirty,这样在GC进行回收标记的时候,就可以避免去扫描整个老年代,直接去扫描CardTable找到哪些为Dirty的CardPage即可。
-
-
-
-
垃圾回收算法
(1)效率:复制算法>标记/整理算法>标记/清除算法(此处的效率只是简单的对比时间复杂度,实际情况不一定如此)。
(2)内存整齐度:复制算法=标记/整理算法>标记/清除算法。
(3)内存利用率:标记/整理算法=标记/清除算法>复制算法。
少量对象存活,适合复制算法:在新生代中,每次GC时都发现有大批对象死去,只有少量存活,那就选用复制算法,只需要付出少量存活对象的复制成本就可以完成GC。 大量对象存活,适合用标记-清理/标记-整理:在老年代中,因为对象存活率高、没有额外空间对他进行分配担保,就必须使用“标记-清理”/“标记-整理”算法进行GC。
- 标记清除
- 拷贝
- 标记压缩(整理)
-
常用的垃圾收集器
随着内存增长而不断演化 几M-几十兆 serial 单线程stw垃圾回收 几十兆-上百兆1g parallel scavenge 1.8 默认垃圾回收器
1g-几十G以上 concurrent 的意思是业务线程和回收线程并行 cms g1 zgc
-
serial(c o 瑞o) young /old
-
old cms/ young serial或parNew
-
cms
-
步骤
- 初始标记
- 并发标记
- 重新标记
- 并发清除
-
调优
-
-
-
parallel scavenge(趴若拉 斯堪未之)/parallel(趴若拉) old
-XX:MaxGCPauseMilis参数是用来控制最大垃圾收集停顿时间的参数,允许的值是一个大于0的毫秒数,收集器将尽力保证内存回收花费的时间不超过用户设定值;该参数并非设置的越低越好,如果太低,虽说停顿时间小了,但是垃圾收集会变得更加频繁,同时也会导致吞吐量降下来; -XX:GCTimeRatio参数 TODO 这个参数书上写的有问题好像;TODO -XX:+UseAdaptiveSizePolicy参数是一个自适应调节策略参数,该参数被激活后,就不需要人工指定新生代的大小(-xmn),Eden与Survivor的比例了(-XX:SurvivorRatio)、晋升老年代对象大小(-XX:PretenureSizeThreshold)等细节参数了,虚拟机会根据档期那系统的运行情况收集性能监控信息,动态调整这些参数以提供最合适的停顿时间或最大的吞吐量。这种调节方式称为垃圾收集的自适应调节策略。 如果对于收集器运作不太了解,手工优化存在困难的话,使用Parallel Scavenge收集器配合自适应调节策略,把内存管理的调优任务交给虚拟机区完成也许是一个不错的选择,只需要把基本的内存数据设置好(如-Xmx设置最大堆),然后使用-XX:MaxGCPauseMilis参数(更关注最大停顿时间)或者-XX:GCTimeRatio(更关注吞吐量)参数给虚拟机设置一个优化目标,那具体细节参数的调节工作就由虚拟机完成了。 自适应调节策略也是Parallel Scavenge收集器区别于ParNew收集器的一个重要特性;
-
G1
-
步骤
-
初始标记
这个阶段需要停顿线程, 但耗时很短
-
并发标记
-
最终标记
对用户线程做另一个短暂的暂停
-
筛 选 回 收
是必须暂停用户线程
-
-
调优参数
-
-
ZGC
ZGC 采用标记 - 整理算法
在 JDK 16 之前,ZGC 会预留(Reserve)一块儿堆内存,这个预留内存不能用于 Java 线程的内存分配。即使从 Java 线程的角度看堆内存已经满了也不能使用 Reserve,只有 GC 过程中搬移存活对象的时候才可以使用 JDK 16 发布后,ZGC 支持就地搬移对象(G1 在 Full GC 的时候也是就地搬移)。这样做的好处是不用预留空闲内存了。
ZGC 只有 3 个需要 STW 的阶段,其中初始标记和初始转移只需要扫描所有 GC Roots,STW 时间 GC Roots 的数量成正比,不会耗费太多时间。再标记过程主要处理并发标记引用地址发生变化的对象,这些对象数量比较少,耗时非常短。可见整个 ZGC 的 STW 时间几乎只跟 GC Roots 数量有关系,不会随着堆大小和对象数量的变化而变化。
ZGC 也有一个缺点,就是浮动垃圾。因为 ZGC 没有分代概念,虽然 ZGC 的 STW 时间在 1ms 以内,但是 ZGC 的整个执行过程耗时还是挺长的。在这个过程中 Java 线程可能会创建大量的新对象,这些对象会成为浮动垃圾,只能等下次 GC 的时候进行回收。
-
步骤
-
初始标记
从 GC Roots 出发,找出 GC Roots 直接引用的对象,放入活跃对象集合,这个过程需要 STW,不过 STW 的时间跟 GC Roots 数量成正比,耗时比较短。
-
并发标记
-
再标记
-
初始转移
并发标记阶段 GC 线程和 Java 应用线程并发执行,标记过程中可能会有引用关系发生变化而导致的漏标记问题。再标记阶段重新标记并发标记阶段发生变化的对象,还会对非强引用(软应用,虚引用等)进行并行标记。
这个阶段需要 STW,但是需要标记的对象少,耗时很短。
-
并发转移
是必须暂停用户线程
-
重定位
-
-
-
shenandoah shai leng dang啊
相同点 基于Region的堆内存布局、大对象存放在特殊的Region中(Humongous Region)、默认的回收策略:有限回收回收价值大的Region。 不同点 (1)支持并发的整理算法(Shenandoah通过转发指针和读屏障来试下并发整理)。在G1中,在进行筛选回收时,必须Stop the world,将回收集合中的存活对象复制到空的Region中。而Shenandoah收集器,在进行复制的过程中可以与用户线程并发执行。 (2)Shenandoah默认不适用分代收集 (3)Shenandoah中摒弃了Region中存放跨代指针的记忆集。而该为链接矩阵,可以理解为一个二维表,如果Region N有对象指向Region M,就在表格N行M列中打上标记。在进行可达性分析时,遍历这个表格就知道哪些Region中有跨代引用。
-
对比
-
优点
优点:
可以指定最大停顿时间、 分 Region 的内存布局、 按收益动态确定回收集。
Mixed GC模式。可以面向堆内存任何部分来组成回收集进行回收, 衡量标准不再是它属于哪个分代, 而是哪块内存中存放的垃圾数量最多, 回收收益最大, 这就是 G1 收集器的 Mixed GC 模式。
G1 将 Region 作为单次回收的最小单元, 即每次收集到的内存空间都是 Region 大小的整数倍, 这样可以有计划地避免在整个 Java 堆中进行全区域的垃圾收集。
不会产生内碎片。与 CMS 的 “标记 - 清除” 算法不同, G1 从整体来看是基于 “标记-整理” 算法实现的收集器, 但从局部( 两个 Region 之间) 上看又是基于 “标记- 复制” 算法实现, 无论如何, 这两种算法都意味着 G1 运作期间不会产生内存空间碎片, 垃圾收集完成之后能提供规整的可用内存。 这种特性有利于程序长时间运行, 在程序为大对象分配内存时不容易因无法找到连续内存空间而提前触发下一次收集。
具有优先级的区域回收;用户可以设置收集停顿时间,优先处理回收价值收益最大的那些 Region, 式, 保证了 G1 收集器在有限的时间内获取尽可能高的收集效率。
-
缺点
在用户程序运行过程中, G1 无论是为了垃圾收集产生的内存占用(Footprint) 还是程序运行时的额外执行负载 (Overload) 都要比 CMS 要高。
在小内存应用上 CMS 的表现大概率仍然要会优于 G1 , 而在大内存应用上 G1 则大多能发挥其优势, 这个优劣势的 Java 堆容量平衡点通常在 6GB 至8GB 之间,
-
JVM三色标记与读写屏障
-
JVM关键参数
-
-
-
-
面试题
-
对象的创建过程
- 赋默认值
- 赋初始值
- 建立连接
-
DCL(doule check lock 单例模式饿汉模式)要不要加volatile问题 指令重排
-
对象在内存中存储布局
-
对象头具体包括什么
-
对象怎么定位
-
对象怎么分配
-
Object o = new Object() 在内存中占用多少字节
-
为什么hotspot 不使用c++对象来表示java对象
-
class对象在堆还是方法区
-
-
-
arthes
-
原理
-
arthas的使用
- dashborad 相当于结合top,top -Hp ,jinfo命令的统计内容 不用来回换算 pid
- thread 可以查看cpu内存和 状态 thread -b 查看是否有死锁情况
- jvm 和jinfo命令差不多
- jad (classname) 反编译 项目代码中引用其它团队写的代码(例如脱敏函数 家庭住址),可能B团队版本升级,A团还是老版本,所以A团队使用jad反编译类,查看代码是否变动
- redefine 在线修改class,本地环境先javac编译成字节码 上传生产环境 eg:redefine TT.class 不用重新发布
- trace 类名 方法名 追查调用方法栈哪个方法耗时长
-
java agent
-
生成文件的存储问题
-
地方
- 架构组提供nas
- hdfs
反压问题
只能同时跑3个台账,但来了5条需要跑的台账消息
需要处理的数据量 > 能够处理的数据量 流式处理中也会出现
-
控制消费速度
-
使用线程池
- 线程池选择
- 线程池调优
-
增加内存或节点
字段查询
存储考虑
-
es
-
数据库
- 索引选择
- sql优化
数仓
维度设计4步骤
-
确定业务过程
-
声明粒度
确认事实表每一行表示什么
-
确认维度
谁 什么 何时 为何 如何
-
确认事实
过程的度量是什么?这一问题来确定事实
分布式锁
问题产生
1.由于后端项目是集群搭建,点击下载台账的请求,可能会打在不同服务器上 2.后台通过表中一个字段是否有值来判断,是否当前已经有人点击过或者定时器触发过 3.同一个台账当天不能重复发送跑数请求到下载中心 4.如果第一个人发送了下载请求,发现为空值,然后准备给下载中心需要用到的参数(这个时间可能会很长),但是表中状态还没有更新,这时候第二个人就发送下载请求了,判断表中状态依然是空值,重复准备参数,并发给下载中心
实现方案
-
基于数据库(唯一索引)
主要是利用数据库的唯一索引来实现,唯一索引天然具有排他性,这刚好符合我们对锁的要求:同一时刻只能允许一个竞争者获取锁。加锁时我们在数据库中插入一条锁记录,利用业务id进行防重。当第一个竞争者加锁成功后,第二个竞争者再来加锁就会抛出唯一索引冲突,如果抛出这个异常,我们就判定当前竞争者加锁失败。防重业务id需要我们自己来定义,例如我们的锁对象是一个方法,则我们的业务防重id就是这个方法的名字,如果锁定的对象是一个类,则业务防重id就是这个类名。
-
悲观锁
-
乐观锁
-
带来问题和解决方案
是否可重入:就以上的方案来说,我们实现的分布式锁是不可重入的,即是是同一个竞争者,在获取锁后未释放锁之前再来加锁,一样会加锁失败,因此是不可重入的。解决不可重入问题也很简单:加锁时判断记录中是否存在unique_mutex的记录,如果存在且holder_id和当前竞争者id相同,则加锁成功。这样就可以解决不可重入问题。
锁释放时机:设想如果一个竞争者获取锁时候,进程挂了,此时distributed_lock表中的这条记录就会一直存在,其他竞争者无法加锁。为了解决这个问题,每次加锁之前我们先判断已经存在的记录的创建时间和当前系统时间之间的差是否已经超过超时时间,如果已经超过则先删除这条记录,再插入新的记录。另外在解锁时,必须是锁的持有者来解锁,其他竞争者无法解锁。这点可以通过holder_id字段来判定。
数据库单点问题:单个数据库容易产生单点问题:如果数据库挂了,我们的锁服务就挂了。对于这个问题,可以考虑实现数据库的高可用方案,例如MySQL的MHA高可用解决方案。
-
-
基于缓存(Redis)
理论上来说使用缓存来实现分布式锁的效率最高,加锁速度最快,因为Redis几乎都是纯内存操作,而基于数据库的方案和基于Zookeeper的方案都会涉及到磁盘文件IO,效率相对低下。一般使用Redis来实现分布式锁都是利用Redis的SETNX key value这个命令,只有当key不存在时才会执行成功,如果key已经存在则命令执行失败。
-
问题和解决方案
是否可重入:以上实现的锁是不可重入的,如果需要实现可重入,在SET_IF_NOT_EXIST之后,再判断key对应的value是否为当前竞争者id,如果是返回加锁成功,否则失败。
锁释放时机:加锁时我们设置了key的超时,当超时后,如果还未解锁,则自动删除key达到解锁的目的。如果一个竞争者获取锁之后挂了,我们的锁服务最多也就在超时时间的这段时间之内不可用。
Redis单点问题:如果需要保证锁服务的高可用,可以对Redis做高可用方案:Redis集群+主从切换。目前都有比较成熟的解决方案。 ———————————————— 版权声明:本文为CSDN博主「头未秃」的原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接及本声明。 原文链接:https://blog.csdn.net/qq_42764269/article/details/122435977
-
Redis就是满足AP(可用性、分区容错性)
-
-
基于Zookeeper
-
问题和解决方案
解决不可重入:客户端加锁时将主机和线程信息写入锁中,下一次再来加锁时直接和序列最小的节点对比,如果相同,则加锁成功,锁重入。
锁释放时机:由于我们创建的节点是顺序临时节点,当客户端获取锁成功之后突然session会话断开,ZK会自动删除这个临时节点。
单点问题:ZK是集群部署的,主要一半以上的机器存活,就可以保证服务可用性。
-
CP(一致性、分区容错性)
zookeeper的集群间数据同步机制是当主节点接收数据后不会立即返回给客户端成功的反馈,它会先与子节点进行数据同步,半数以上的节点都完成同步后才会通知客户端接收成功。并且如果主节点宕机后,根据zookeeper的Zab协议(Zookeeper原子广播)重新选举的主节点一定是已经同步成功的。
-